1. Le bon point de départ : le premier goulot d’étranglement
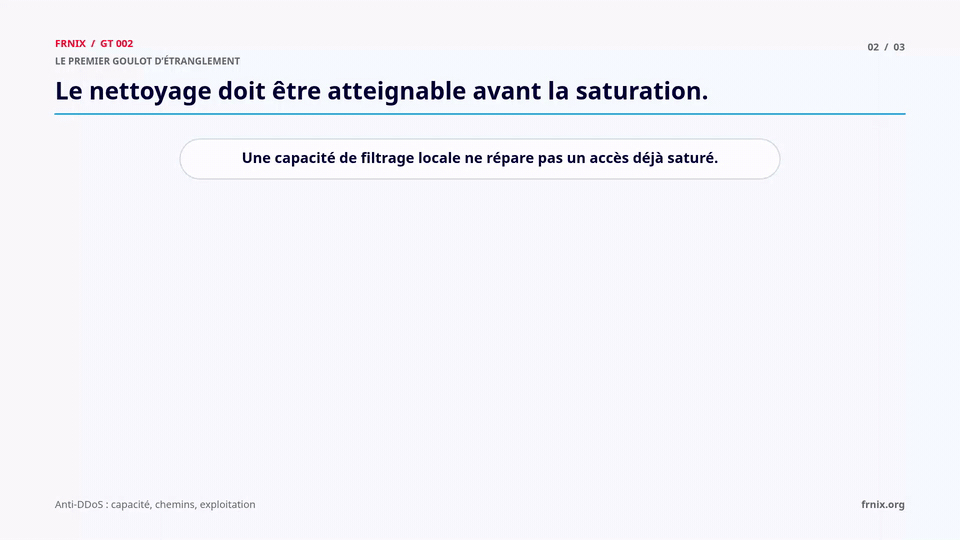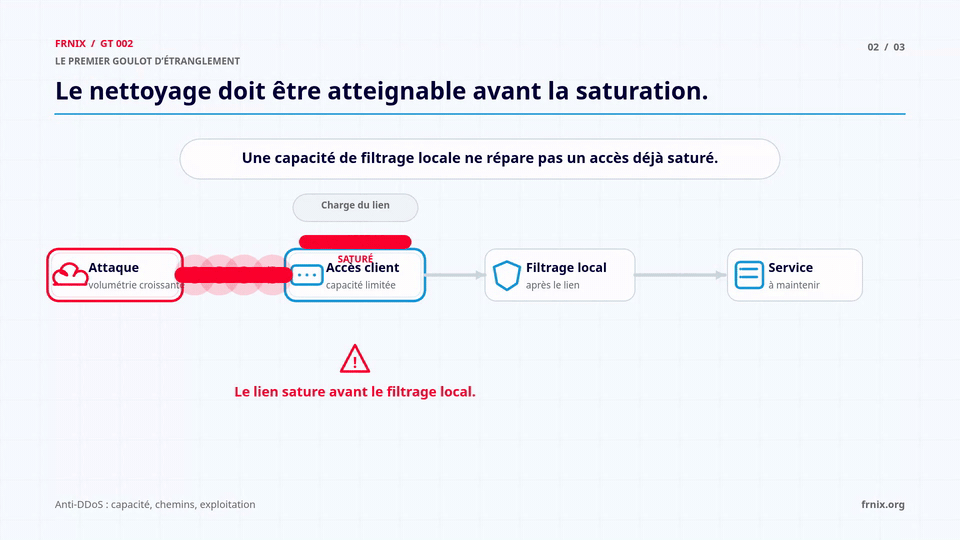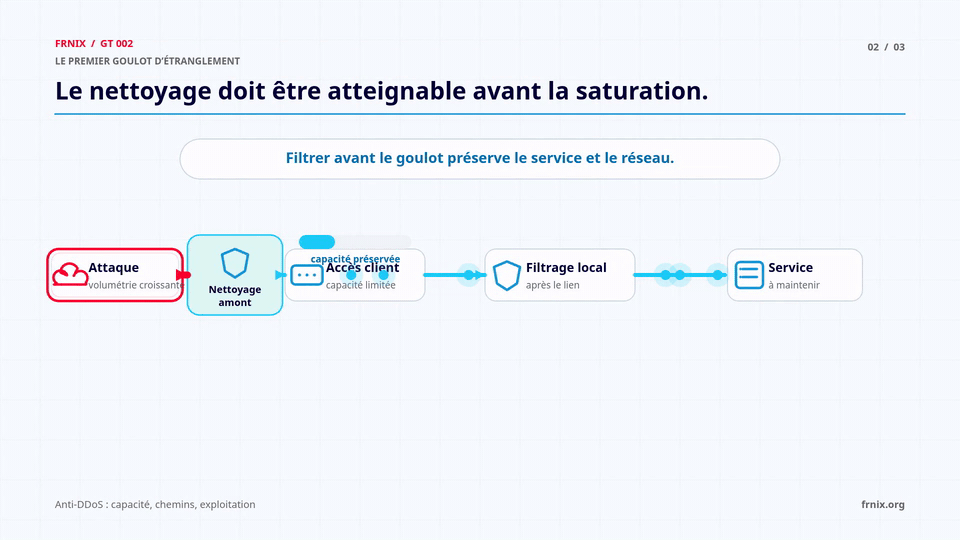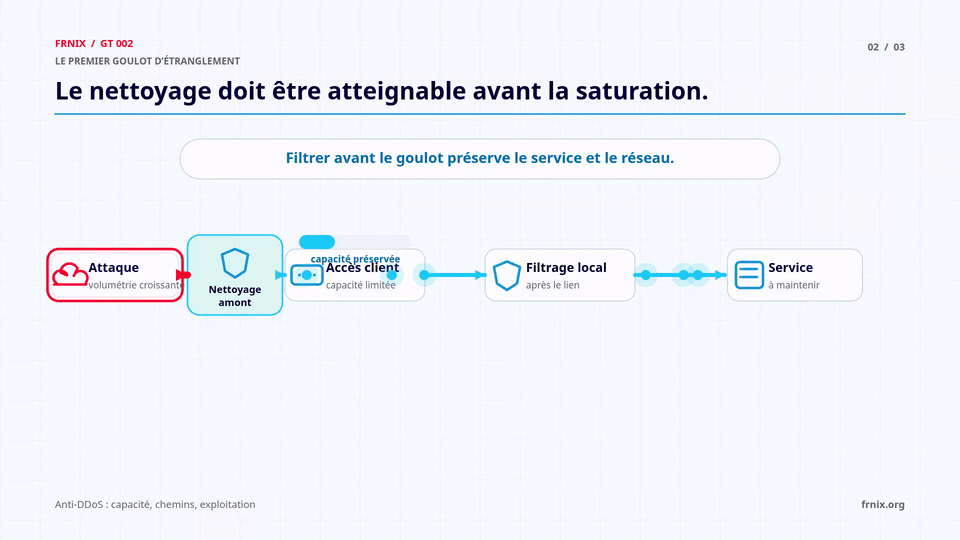
Dans un réseau de peering, la première question face au DDoS n’est pas « quelle capacité de nettoyage ? ». C’est : qu’est-ce qui sature en premier, et par quel chemin le trafic y arrive-t-il ? Une attaque modeste à l’échelle d’un réseau amont peut suffire à saturer un accès client, un firewall, un load balancer ou une API.
Une capacité de nettoyage élevée ne protège pas un service si le trafic ne peut pas rejoindre le filtrage avant la saturation.
2. Distinguer trois problèmes au lieu d’un
Il est utile de séparer la protection volumétrique L3/L4, la protection applicative et la résilience d’accès/routage. Un WAF peut être pertinent pour une application, mais ne remplace pas automatiquement la protection d’un lien qui sature. Une mitigation volumétrique ne résout pas, à elle seule, un abus ciblant une API.
L’architecture devient plus lisible quand chaque mécanisme a un rôle, un périmètre et des limites explicitement documentés.
3. La carte de risque inclut transit et peering
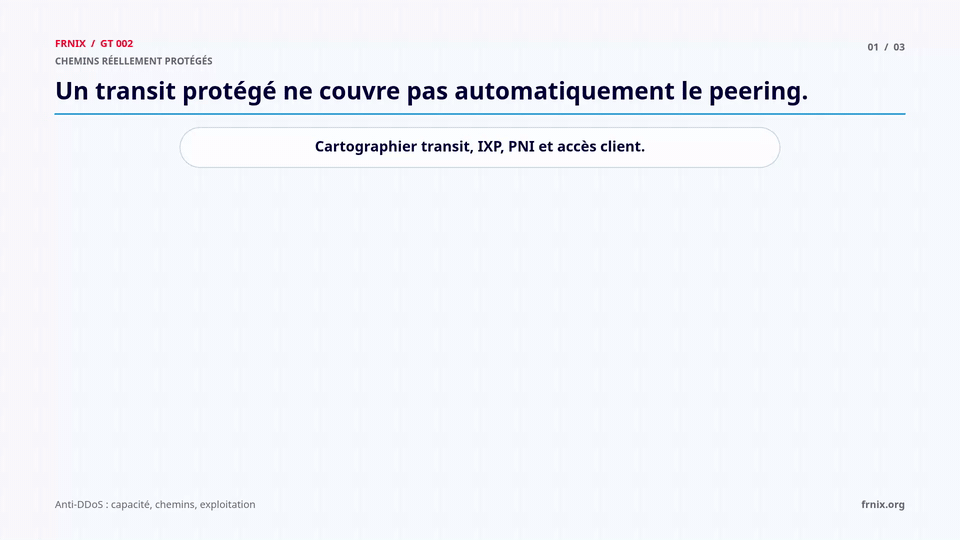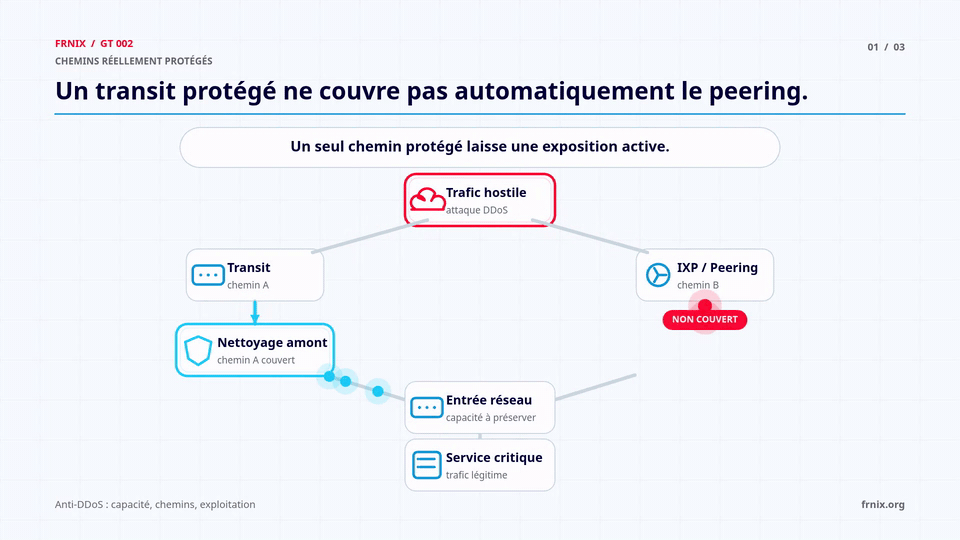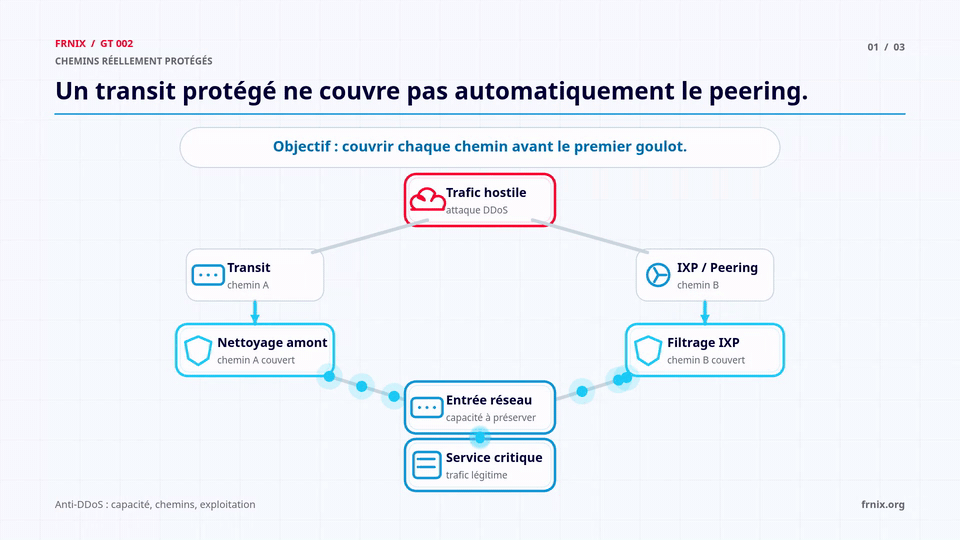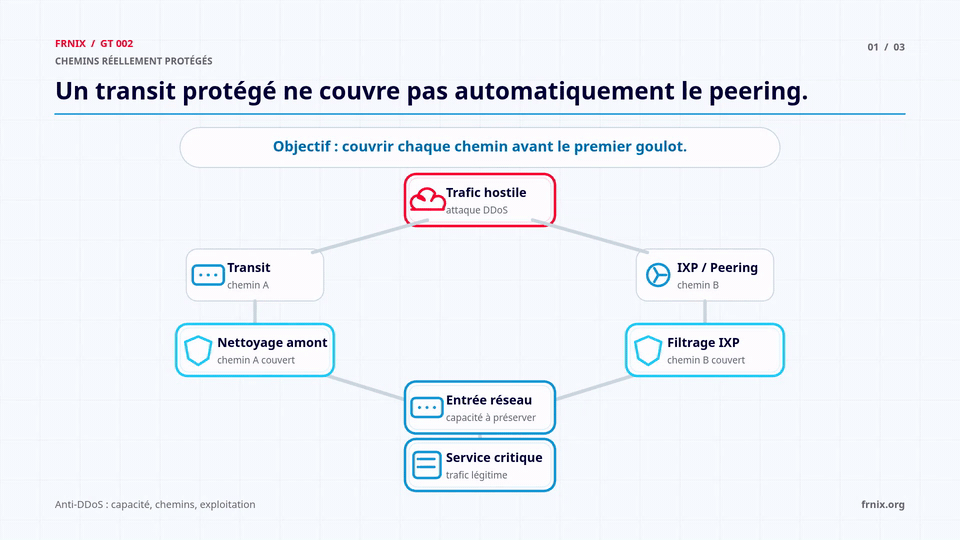
La topologie de protection doit couvrir transit, IXP, interconnexions privées, accès client, routes de secours et retour du trafic légitime après filtrage. Dans un contexte de peering, une protection placée uniquement chez un transitaire peut ne pas couvrir une même exposition.
Les préfixes et services critiques, les liens d’entrée, le premier risque de saturation, le mécanisme de déviation et le chemin de retour doivent être schématisés et connus des équipes d’astreinte.
4. Le point de nettoyage doit être atteignable
Le filtrage amont est recherché parce qu’il évite que l’attaque consomme la capacité d’accès ou de backbone. Il faut néanmoins vérifier la capacité de transport jusqu’au point de nettoyage, les chemins réellement couverts, les conditions d’activation, la préservation du trafic légitime et la visibilité pendant l’incident.
Le nombre de centres de nettoyage est moins important que la couverture utile : chemin réel, capacité disponible et conditions de déviation.
5. Dévier le trafic sans perdre l’architecture
DNS, BGP et GRE ont des usages distincts. DNS peut déplacer un service, pas protéger une IP directement ciblée. BGP demande une politique claire et une lecture de son effet sur le multihoming. GRE doit être évalué face à la capacité, à la latence et aux scénarios volumétriques.
La question opérationnelle devient : quels flux sont déviés, à partir de quel signal, sur quel chemin, avec quelle capacité et quelle réversibilité ?
6. Observer avant de filtrer
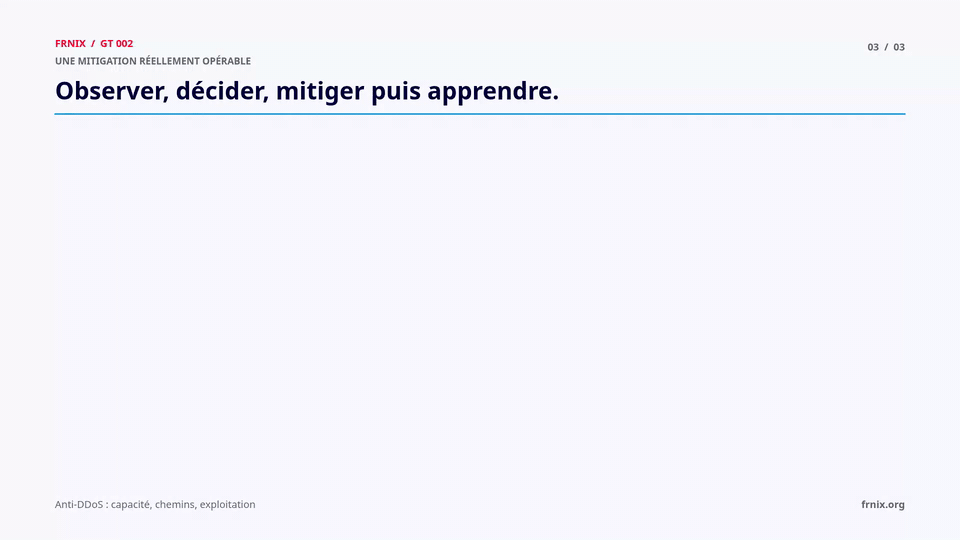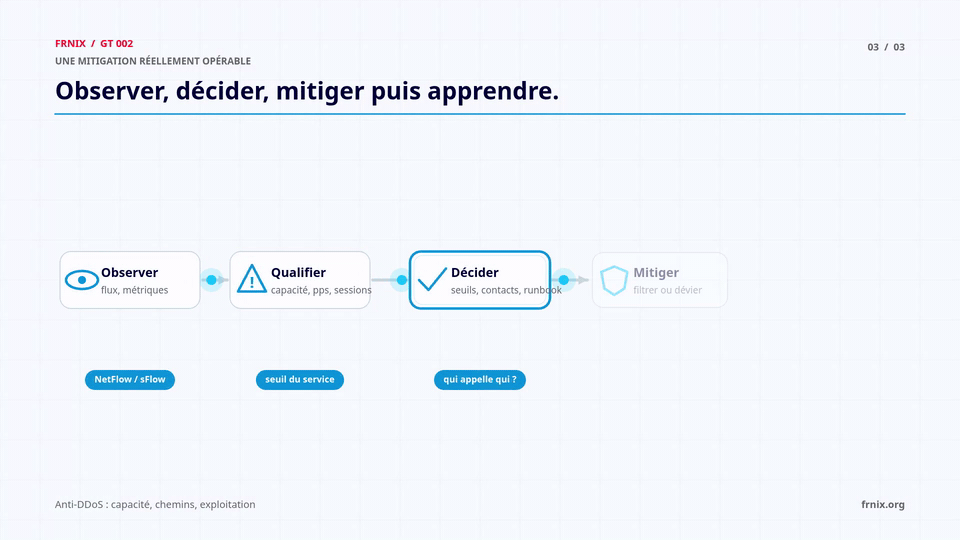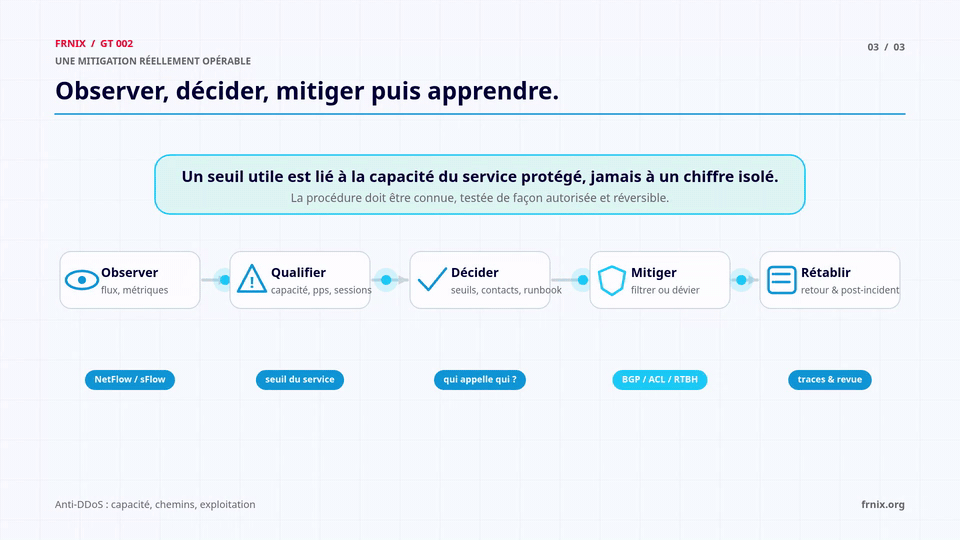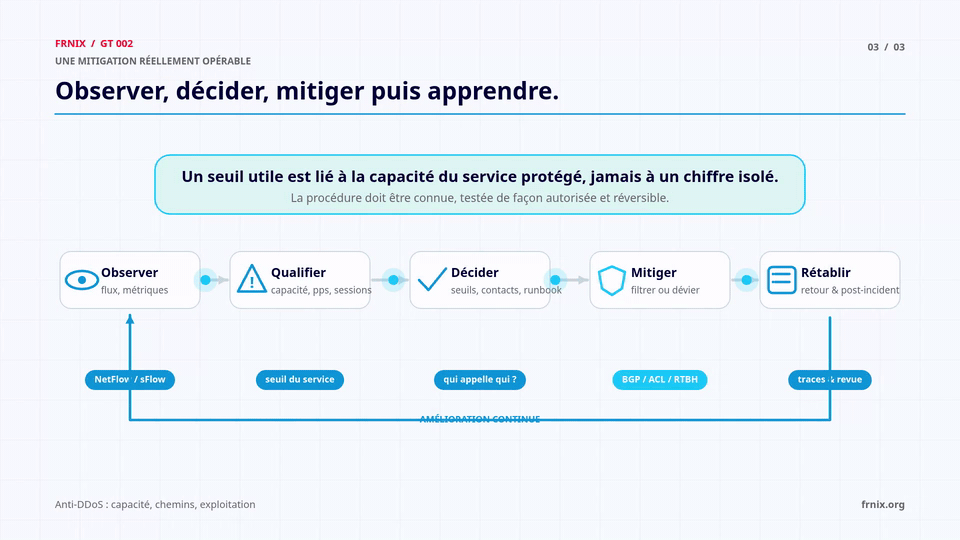
NetFlow/sFlow, compteurs d’interface, métriques applicatives, baselines et informations amont permettent de transformer une alerte en décision. Les seuils doivent être reliés aux capacités réellement protégeables : lien, pps, sessions, serveur, firewall ou API.
L’absence de symptôme local ne prouve pas l’absence d’attaque ; le trafic peut avoir été filtré en amont ou saturer avant le point de mesure. La visibilité doit donc englober les chemins de transport, pas seulement les équipements internes.
7. Blackholing, filtrage et protection applicative
Le blackholing reste une mesure de sauvegarde : il peut préserver l’infrastructure et les autres services, mais il supprime le trafic vers la destination ciblée. Les ACL, règles de filtrage et mécanismes de distribution de règles complètent une stratégie de mitigation seulement si leur portée, leur délai d’application et leur exploitation sont maîtrisés.
La protection applicative est une couche supplémentaire. Elle doit être évaluée selon les services qu’elle voit réellement et les contraintes techniques qu’elle implique. La segmentation des responsabilités évite les faux sentiments de sécurité.
8. Une protection se maintient : runbooks, tests autorisés et post-incident
Un dispositif anti-DDoS ne reste efficace que s’il est exploité : procédures de contact, matrice de décision, liste des préfixes et services critiques, droits d’activation, communication de crise et retour d’expérience structuré.
Les tests de résistance peuvent aider à calibrer la détection et les procédures, mais uniquement en laboratoire ou avec l’accord explicite de toutes les parties. Une fois le trafic rétabli, la revue doit associer réseau et sécurité : changements d’administration, authentifications, sorties de données et modifications DNS/BGP peuvent révéler qu’un DDoS a servi de diversion.
9. Comparer avec des scénarios, pas avec un chiffre isolé
Pour comparer une solution ou un service, partez de scénarios documentés et des chemins réellement utilisés. La capacité affichée ne répond pas à elle seule aux questions de couverture, de saturation amont, d’activation, d’impact routage, de visibilité ou d’exploitation.
L’objectif n’est pas de trouver une réponse universelle. Il est de s’assurer que le service choisi correspond au réseau, aux applications et à la capacité réelle de l’équipe à l’exploiter
Membres contributeurs du GT 002
Les organisations suivantes ont contribué aux travaux du cycle. Cette liste ne constitue pas un relevé de présence à chaque réunion et n’attribue aucun propos, retour d’expérience ou position à une organisation en particulier.